Chip Huyen 不是典型的「AI 大佬」——她没有发过改变行业的论文,也没训练过 GPT-4。但她在 NVIDIA、Snorkel AI、Claypot AI、Voltron Data 摸爬滚打多年,在 Stanford 教 ML Systems Design,2025 年出版的《AI Engineering》成为 O’Reilly 平台阅读量最高的书。她的核心判断只有一句:AI 落地是系统工程,而不是模型竞赛。
速览卡:这位大佬和他说了什么
 | 大佬 | Chip Huyen |
| 身份 | AI 工程作家、Voltron Data 前 VP of AI & OSS、Claypot AI 联合创始人、Stanford CS 客座讲师 | |
| 出处 | 个人博客 huyenchip.com、《AI Engineering》专著(O’Reilly 2025,全平台阅读量第一)、Stanford CS329A/X 课程 | |
| 时间 | 2024-2026 年持续更新的博客与书籍连载 | |
| 核心观点 | AI 落地是系统工程而非模型竞赛;“部署容易,可靠部署难”;数据质量比向量数据库选择更重要;微调是最后手段;推理时计算与 KV Cache 优化决定生产成本 |
Chip 说了什么
Chip Huyen 不是典型的 “AI 大佬”。她没有发过改变行业的论文,也没有训练过 GPT-4。她在 NVIDIA、Snorkel AI 待过,在 Stanford 教 ML Systems Design,2021 年和合伙人一起创办了 Claypot AI(专注实时机器学习数据流)。2024 年初她加入 Voltron Data 担任 VP of AI & OSS,2025 年出版《AI Engineering》一书,全长 15 万字,在 O’Reilly 平台成为阅读量最高的书。她的核心战场不在模型本身,而在 “模型如何从 notebook 走进生产”。
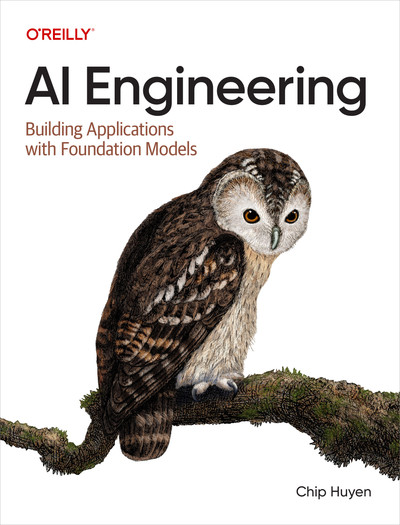
她在书里和博客中反复强调一句话:
“Deploying is easy, deploying reliably is hard.”
翻译:“部署容易,可靠部署难。”
这句话的潜台词是:过去三年,整个 AI 圈都在为“能不能跑通”兴奋,但真正决定一个 AI 产品商业化能不能成的,是“能不能稳定跑通”。一个医院部署 AI 影像诊断系统,需要的不是 “95% 准确率” 的模型,而是“99.9% 可用性、毫秒级延迟、HIPAA 合规、任何异常都能立即告警” 的系统。这是工程问题,不是研究问题。
她另一句被广泛引用的话是:
“Data quality matters more than which vector database you choose.”
翻译:“数据质量比选择哪个向量数据库更重要。”
这句话直接挑战了 2024 年 AI 圈对 RAG 和向量数据库的过度关注。她认为,一个项目的真正瓶颈不在于用了 Pinecone 还是 Weaviate,而在于你收集的领域数据是否高质量、是否持续更新、是否有合理的评估机制。在医疗、法律、金融等高价值领域,一个使用 Postgres 全表扫描 + GPT-4 的简单 RAG 系统,往往比一个用最先进向量数据库 + 简陋文档处理的系统更靠谱。
关于“要不要微调”的问题,Chip 给出的判断同样反常识:
“Fine-tuning should be the last resort.”
翻译:“微调应该是最后手段。”
她的逻辑是:在大多数应用场景里,先把“预训练 + RAG + 好的 prompt engineering” 做到位,就已经能解决 80% 的问题。等到这三条路径都摸到天花板,再考虑微调——因为微调是昂贵且脆弱的,每次微调都相当于重新训练一遍,而 RAG 和 prompt 是低成本可调试的。
在《AI Engineering》第 9 章,Huyen 把 LLM 推理拆成了两个完全不同的阶段,并给出了衡量生产性能的关键指标:
“For autoregressive LLMs, inference consists of two distinct phases with different bottlenecks: Prefill: The model processes the input prompt in parallel. This phase is compute-bound. Decode: The model generates the output one token at a time. This phase is memory bandwidth-bound.”
翻译:“对于自回归 LLM,推理由两个不同阶段组成,每个阶段的瓶颈完全不同:Prefill 阶段模型并行处理输入 prompt,是计算瓶颈;Decode 阶段模型逐 token 生成输出,是内存带宽瓶颈。”
这一区分非常重要——很多团队的 “推理优化” 方案之所以失败,是因为他们把 Prefill 和 Decode 当成同一个问题来优化。Huyen 强调,必须分别为两个阶段做性能监控(TTFT、TPOT、Throughput、MFU、MBU),然后针对瓶颈分别优化。
背景:为什么 AI 工程在 2024 年突然变得重要
2022 年 11 月 ChatGPT 发布后,整个 AI 行业进入了一个奇怪的 “危机”:研究能力被开源复现的速度太快了。Llama、Mistral、Qwen 这些模型在性能上迅速追上了闭源大模型,闭源公司被迫靠“规模优势”继续领跑。但 2024 年 DeepSeek-V3 的出现证明:开源模型在算法层面的差距已经缩小到几个月,研究”不再是最有壁垒的环节。
壁垒转移到了哪里?工程。
一个 LLM 模型从训练完成到被 1 亿人使用,中间需要的工程基础设施包括:推理服务的 GPU 调度、prompt 缓存、KV Cache 优化、监控告警、A/B 测试、用户反馈收集、模型版本管理、灰度发布、回滚预案。这些工作在过去三年从“不重要” 变成“决定生死”。这也是为什么《AI Engineering》成为了 2025 年最畅销的技术书。
Chip Huyen 是把“AI 工程”这个概念系统化的关键人物。她的书不教你怎么调模型,而是教你怎么把模型变成一个能持续跑的产品。她从四个层次把 AI 工程拆解:
- 第一层:模型评估(怎么测你的模型真的好用?)
- 第二层:推理优化(怎么让模型跑得快、省钱?)
- 第三层:AI 系统架构(怎么把多个模型、工具、数据流组合成产品?)
- 第四层:用户反馈循环(怎么用真实用户数据持续改进系统?)
这四个层次构成了一个完整的产品闭环。任何一个层次出问题,整个产品就会失败。
核心观点展开:AI 工程的四个层次
第一层是模型评估。Huyen 在书中反复强调:“没有评估就没有迭代”。她把 LLM 评估分成三类:
- 基于规则的评估(exact match、F1、precision/recall);
- 基于模型的评估(用 GPT-4 当裁判,给其他模型打分);
- 基于人类的评估(专家打分)。
她警告,基于模型的评估在 2025 年已经成为主流,但它有一个隐藏陷阱:评估模型自己也会随版本变化,导致你测出来的“提升”其实是幻觉。Huyen 建议:永远保留 100 个人类标注的 gold set,用它定期校准模型评估。
第二层是推理优化。这是 Huyen 在 2024-2025 年写得最多的部分。她系统性地梳理了三个层级的优化手段:
模型层优化:
- 量化(Quantization):从 FP16 到 INT8、INT4 是最有效、最广泛使用的优化。把 16-bit 浮点权重降到 8-bit 或 4-bit 整数,模型大小立即缩小 50-75%,推理速度通常也能提升 2-4 倍。
- 蒸馏(Distillation):训练一个小的“学生模型”模仿大的“教师模型”。小模型可以保留大模型 90% 的能力,但推理成本降到 1/10。
- 剪枝(Pruning):移除不重要的权重,让模型更稀疏。
- 推测解码((Speculative Decoding):用一个小的“草稿模型”先生成一段文本,然后大模型并行验证。可以让解码速度翻倍,质量无损。
- 并行解码((Medusa):修改模型架构,让它能同时生成多个未来的 token,打破顺序依赖。
服务层优化:
- 连续批处理((Continuous Batching):vLLM 的核心创新。新请求在旧请求完成时立即加入批次,让 GPU 利用率始终接近 100%。
- Prefill 和 Decode 解耦:因为两个阶段瓶颈不同,把 Prefill 放在 A100 集群,Decode 放在 H100 集群,能显著提升整体吞吐。
- Prompt 缓存:很多 prompt 包含重复片段(如系统提示),缓存这些片段的 KV Cache,能让延迟和成本降到 1/10。
- 并行策略:Tensor Parallelism(拆分单个矩阵乘法到多 GPU)和 Pipeline Parallelism(拆分不同层到不同 GPU)。
硬件层优化:FlashAttention 通过重排注意力计算的顺序,把 GPU 显存访问降到最小,能让训练和推理都快 2-4 倍。PagedAttention(vLLM 的核心)通过虚拟内存式分页管理 KV Cache,把显存碎片化问题彻底解决。
第三层是 AI 系统架构。Huyen 提出了一个“渐进式架构”的方法:
- 第 1 步:增强上下文(接外部知识库、做 RAG)
- 第 2 步:加护栏(防 prompt 注入、防幻觉、防越狱)
- 第 3 步:加路由(不同子任务用不同模型)
- 第 4 步:加缓存(响应缓存、Embedding 缓存)
- 第 5 步:加 Agent(让模型能调用工具)
- 第 6 步:加用户反馈循环(让系统能从真实使用中学习)
这个方法的核心是“从最简单的系统开始,按需求逐步加复杂度”。Huyen 警告,很多 AI 项目的失败不是因为加得不够多,而是因为加得太多——一次性引入 Agent + RAG + 微调 + 监控,最后无法调试任何一个。
第四层是用户反馈循环。Huyen 认为这是最被忽视但最重要的环节:“没有用户反馈的 AI 系统是一个静态系统,它会在三个月后过时。”她建议:每次用户交互都收集 (input, output, user_action, user_feedback) 四元组,作为下一轮模型微调或或评估优化的种子数据。这个反馈循环让产品从“一次性发布”变成“持续迭代”。
行业内的讨论与不同声音
Chip Huyen 的观点在业内获得了广泛共鸣,但也引起了一些争议。
最激烈的反对声音来自 Anthropic 和 OpenAI 的研究人员。他们认为 Huyen 的的 “可靠性优先” 思路虽然正确,但与当前的“能力优先”范式矛盾。在他们的视角里,模型的智能水平才是最关键的,工程问题可以用“更大的模型”来解决。Anthropic 在 2025 年发布的 Claude Code 就是一个反例——他们靠“更强的模型 + 更好的 prompt + 简单的工程” 做出了一个生产级 Agent,没有遵循 Huyen 建议的所有工程规范。
温和的支持者是 Hugging Face 的工程团队。他们的 Transformers、PEFT、TRL 库都遵循 Huyen 描述的工程原则。Hugging Face 的工程师在 2025 年的一次访谈中说:“Chip 把我们做的工作写成了一本书,而且写得比我们自己的文档还清楚。”
中国 AI 圈的反馈更复杂。一方面,字节跳动的豆包模型团队在 2025 年初公开发表过一份 28 页的“LLM 推理优化实战”白皮书,里面的思路与 Huyen 的书有大量重合(如连续批处理、KV Cache 优化、推测解码)。另一方面,深度求索(DeepSeek)的工程团队走的是“极致优化”路线,他们通过 MoE 架构 + FP8 训练 + 改进的注意力机制,把训练成本压到了 GPT-4 的 1/10,这与 Huyen 的“用工程换可靠性”思路一致。
Yann LeCun 在 2024 年多次公开批评“LLM 路线不可靠”,但他的替代方案(世界模型)至今没有产品化。他对工程问题的看法与 Huyen 类似——核心问题不是模型能不能做,而是能不能在真实世界里稳定做。LeCun 的世界模型在 Meta 内部被工程团队批评为“理论太复杂、无法落地”。
Karpathy 在 2024 年底的“对着 AI 漫谈十分钟”演讲里也呼应了 Huyen 的观点。他说:“LLM 的可靠性比它的能力更重要。如果一个模型 90% 的时候是对的、10% 的时候是错的,你没法把它放进任何严肃的工作流。”
横向扩展:AI 工程的边界
把 AI 工程放到更大的软件工程图谱里看,可以发现一个有趣的对比:
传统软件工程已经走了 60 年,从瀑布模型到敏捷开发到 DevOps 到 GitOps,工程方法论不断成熟。但核心目标始终没变——让软件系统更可靠、更可维护、更可扩展。
AI 工程面临的不确定性比传统软件大得多:
- 输入分布漂移:用户问的问题分布每天都在变,今天准确的 prompt 明天可能就失效。
- 模型行为不可预测:同一个 prompt 在不同模型版本下可能产生不同结果。
- 评估信号弱:很多任务的”正确”没有明确定义(创意写作、对话流畅度)。
- 外部依赖不可控:LLM API 可能随时下线、模型可能随时升级、定价可能随时调整。
这些不确定性要求 AI 工程师具备一种新的能力——Huyen 把这种能力称为“工程判断力”(Engineering Judgment):知道什么时候信任模型、什么时候不信任;知道什么时候优化值得、什么时候不值得;知道什么时候该重写、什么时候该调参。
这种判断力没有一个简单的算法可以替代,只能在生产环境里一次次犯错、一次次调优、一次次反思才能积累。这也是为什么《AI Engineering》成为 2025 年最畅销的技术书——它不是教人一个具体的工具或框架,而是教人一种思维方式。
总结:2026 年 AI 工程师的必备能力
回到最初的问题:AI 工程是不是炼丹?Chip Huyen 的回答是:不是。
炼丹关注的是“配方”(模型架构、超参数、数据集),AI 工程关注的是“产品”(系统架构、推理性能、用户反馈、可靠性)。前者是研究人员的领域,后者是工程师的领域。
对于 2026 年想要进入 AI 行业的工程师,Chip 的建议是:
- 先学会工程基础:Docker、Kubernetes、Prometheus、Grafana、CI/CD、负载均衡、A/B 测试——这些不是 AI 特有的,但 AI 系统部署离不开它们。
- 学会读模型论文:不是为了复现,而是为了知道不同模型的能力边界和适用场景。
- 学会评估:能设计 gold set、能用 GPT-4 当裁判、能分析 bad case——这是 AI 工程师最重要的技能。
- 学会用工程换可靠性:连续批处理、KV Cache 优化、Prompt 缓存——这些工程手段能让你模型的 P99 延迟从 5 秒降到 500 毫秒。
- 学会从用户反馈中学习:让你的系统能记录每一次用户交互、每一次拒绝、每一次不满意——这些数据是下一轮迭代的种子。
Chip 在书的最后写了一句话:“The best AI system is not the one with the smartest model, but the one that is most useful to its users.”(最好的 AI 系统不是模型最聪明的那个,而是对用户最有用的那个。)
这与她的另一句话呼应:“Deploying is easy, deploying reliably is hard.”
这两句话构成了 AI 工程的两个支柱:可靠性与有用性。研究人员关心智能水平,工程师关心可靠部署。两者必须结合起来,才能让 AI 真正从 demo 变成产品。
参考来源
- Chip Huyen 个人博客(AI Engineering 官方配套资源)
- AI Engineering: Building Applications with Foundation Models(O’Reilly 2025)
- AI Engineering – Chip Huyen – Complete Book Summary & All chapters(2026-02-12)
- How can cloud providers build cost-efficient AI inference engines for sovereign clouds by 2026?
- How is Chip Huyen’s Vision Reshaping Small Language Models for Secure Medical AI?
- Chip Huyen: Pioneering Machine Learning and MLOps
- Top 10 LLMs/AI Blogs to Follow in 2026
- Stanford CS329A: Building Large Language Models for Production
- AI Engineering GitHub 配套仓库