François Chollet 这个名字,对很多人来说可能首先联想到 Keras——那个让深度学习入门变得简单的框架。但对关注「智能到底是什么」的人来说,Chollet 更重要的身份是 ARC 基准的创建者,以及一个持续七年追问「如何衡量智能」的人。2026 年 8 月 14 日,他在 X 上抛出了一个判断,可能比任何单个模型的发布都更值得拆解:ARC-AGI-3 上所有顶尖的解法,用的都是同一种范式——让 LLM 生成可执行的「符号世界模型」代码,而不是靠 token 预测直接解题。而他进一步说:这「不是只会在 ARC 上发光,而是 AI 长期的大部分走向」。
速览卡:这位大佬和他说了什么
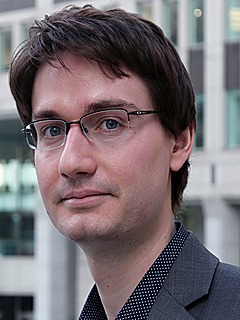 | 大佬 | François Chollet |
| 身份 | Keras 作者、ARC 基准创建者、ARC Prize 基金会联合创始人、Ndea 联合创始人 | |
| 出处 | X(Twitter)@fchollet,2026 年 8 月 14 日系列推文 | |
| 时间 | 2026 年 8 月 14 日 | |
| 核心观点 | ARC-AGI-3 顶尖解法都是「LLM 引导的符号世界建模」;这将是 AI 长期的主要方向 |
Chollet 说了什么
Chollet 这组推文的直接触发,是一个开发者 @jeremyberman 在 ARC-AGI-3 上的一次尝试:用 LLM 引导、即时合成符号世界模型,单次生成 269 个程序、约 12700 行代码。Chollet 对此给出了一个非常明确的背书:
All of the top-performing harnesses on ARC-AGI-3 use this style of approach — LLM-guided on-the-fly synthesis of a symbolic world model, i.e. writing executable code to encode an understanding of the causal mechanics.
(译文)ARC-AGI-3 上所有顶尖的 harness(评测框架),用的都是这种风格的方法——由 LLM 引导、即时合成符号世界模型,也就是写可执行代码来编码对因果机制的理解。
他随后补了一句更关键的判断,这句话把一次具体的技术观察,上升到了对整个 AI 方向的预测:
This is not an approach that will only shine on ARC 3. This is where most of AI is headed in the long run.
(译文)这不是一个只会在 ARC-3 上发光的方法。这是 AI 长期的大部分走向所在。
他还在推文里引用了一个更早(7 月 2 日)就表达过的判断,把这个观点的时间线拉得更长:
Eventually, much of AI will converge towards intuition-guided symbolic world modeling, i.e. deep learning-guided program synthesis. It is inevitable.
(译文)最终,AI 的很大一部分会收敛到「直觉引导的符号世界建模」,也就是「深度学习引导的程序合成」。这是不可避免的。
这三句话,构成了一个完整的、层层递进的判断:从一个基准的解法模式,到一个 Agent 架构的趋势,再到一个关于 AI 终局形态的预言。
背景:ARC 到底在测什么,为什么它值得较真
要理解 Chollet 这个判断的分量,得先理解 ARC 这个基准的独特之处,以及它为什么和市面上的「刷分基准」如此不同。
ARC(Abstraction and Reasoning Corpus,抽象与推理语料库)诞生于 Chollet 2019 年的论文《On the Measure of Intelligence》。这篇论文提出了一个尖锐的批评:AI 研究界一直在「测错东西」。大多数基准评估的是一个模型在特定任务上的「技能」(skill),但技能是可以「买」来的——用海量训练数据或手工先验就能堆出来。一个训练了百万盘棋的模型下棋很厉害,但这说明不了它的「通用推理能力」。
Chollet 主张,智能应该被定义为「技能习得效率」(skill-acquisition efficiency):一个系统在给定极少经验和固定先验的情况下,泛化到新任务的能力有多强。为了把这个定义落到实处,他设计了 ARC——一组彩色小网格拼图,人类看一眼就能解,但每个任务都是全新的、无法靠记忆(memorization)破解。ARC 因此成了少有的「抵抗死记硬背」的基准:高分意味着推理,而不是回忆。
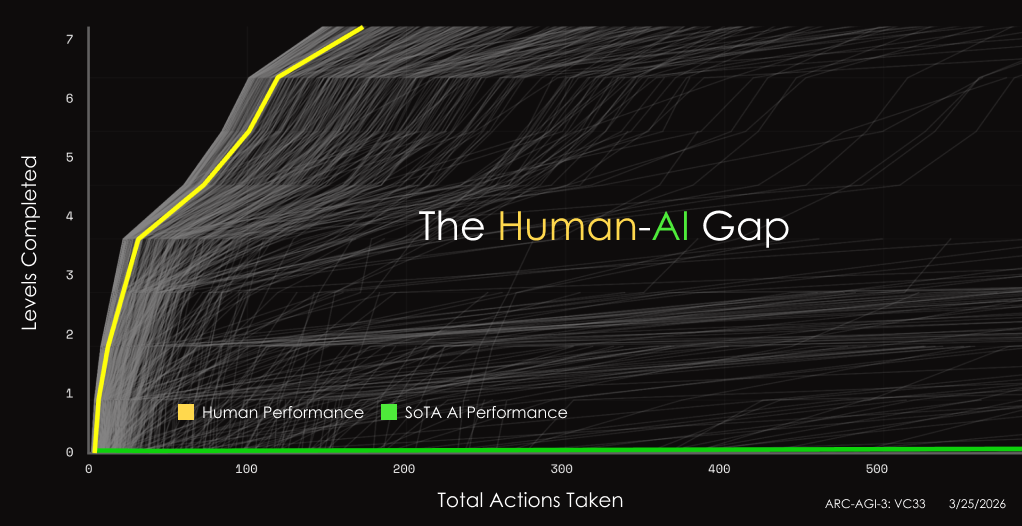
ARC 的进化史,恰好记录了 AI 能力的几次跃迁。ARC-AGI-1(2019)在 OpenAI 的 o3 于 2024 年 12 月冲到 87.5% 后被「攻破」;于是 ARC-AGI-2(2025 年 3 月)重置难度,把顶尖分数重新压回约 4%;而 ARC-AGI-3(2026 年 3 月 25 日发布)则做了一次更彻底的范式升级——不再让模型做「单次输入-输出」的静态拼图,而是让它进入一个「回合制、可交互」的关卡环境,自己去探索规则、构建内部世界模型、推断目标、然后规划并执行方案。
ARC-AGI-3 由 135 个手工构建的环境组成,运行在自定义 Python 引擎里(每秒 1000 帧),每个环境是一个 64×64 的网格、16 种颜色,Agent 的动作空间极小(最多 5 个键 + 撤销 + 可选坐标点击)。最关键的是:Agent 永远不会被告知目标和操作方式,它必须自己发现这两者。发布初期,Anthropic、Google DeepMind、OpenAI、xAI 的前沿模型在 semi-private 集上全部低于 1%,而未经训练的人类能解出全部环境。
核心观点展开:「直觉引导的符号世界建模」到底指什么
Chollet 用的「直觉引导的符号世界建模」这个词,听起来抽象,拆开其实很具体。它对应的是两种截然不同的「解题范式」的对立。
范式一:端到端 token 预测。这是主流 LLM 的默认做法——把一个问题塞进去,让模型通过「预测下一个 token」一路生成答案。它的问题是:模型的「推理」是隐式的、不可检视的,一旦在长程、多步、需要精确因果的问题上出错,你既不知道为什么错,也没法局部修正——只能重新生成一遍。
范式二:LLM 作为「合成引擎」,生成可执行的符号世界模型。这是 Chollet 背书的方法。在这个范式里,LLM 的角色不是「直接解题」,而是「生成一段可执行程序」——一个 parser、一个 simulator、一个显式编码了环境因果规则的世界模型。这段代码可以被独立运行、测试、调试,而且调试过程和「生成它的 LLM」是解耦的。
Chollet 点出的关键区别就在这里:在范式一里,LLM 的推理是「一次性」的、不可验证的;在范式二里,LLM 产出的是一段「可验证、可复用、可独立演化」的代码。你跑它、看它对不对、改它、再跑——这个「闭环」里,代码才是那个真正的「推理结果」,LLM 只是负责「把直觉翻译成代码」的那一步。
为什么要叫「直觉引导」?因为 LLM 在这里承担的角色,恰恰是它最擅长的——用「直觉」(对问题结构的模糊、快速的把握)去引导「符号」的精确生成。而「符号世界建模」则是用代码把环境的因果规则显式表达出来。合起来,「直觉引导的符号世界建模」就是:用神经网络的直觉去生成精确的符号程序,再用程序的确定性去弥补神经网络的不可靠。
这和「程序合成」(program synthesis)这个老领域一脉相承,但多了一个关键的变量——「深度学习引导」。传统的程序合成是纯粹的符号搜索,效率低、难扩展;而 LLM 的加入,等于给符号搜索装了一个「直觉发动机」,让它在巨大的程序空间里能快速找到有希望的候选。
行业内的讨论与不同声音
Chollet 的判断在社区里激起的反应,集中在几个层次。
最直接的响应,是对「ARC-AGI-3 到底测出了什么」的重新审视。ARC-AGI-3 发布六个月后,局面发生了戏剧性变化:2026 年 9 月 3 日,OpenAI 宣称其 GPT-6 Astra 在 ARC-AGI-3 上「饱和」——ARC Prize 基金会同日发布的验证结果是:Standard harness 下 62.7%,新的 Provider Adapter harness 下 99.9%。这个 99.9% 的数字背后有一个重要的技术细节——Provider Adapter harness 会「在回合之间保留模型的隐藏推理」,也就是说,它允许模型在一个跨回合的连续推理里工作。这立即引发了争议:这 99.9% 里,有多少属于模型本身,有多少属于「外面的 harness」?
Chollet 本人对这类「分数」保持着清醒,而且主动踩过刹车。8 月 14 日的同一组推文里,他还专门澄清了一件事,防止社区把「公开演示集」的分数当成真成绩:
Regular reminder — the set of public ARC 3 games is called “demonstration set”, not “eval set” nor “training set”. It is not meant to be used as training data, and it is not meant to be used as an eval. Scores on the public demonstration set are not indicative of scores on the actual benchmark. The demonstration set is intended to demonstrate the format and drive human engagement. The private eval set is substantially more difficult and more novel.
(译文)例行提醒——ARC 3 的公开游戏集叫「演示集」,既不是「评测集」,也不是「训练集」。它不是用来当训练数据的,也不是用来当评测的。在公开演示集上的分数,不代表在真正基准上的分数。演示集是为了展示格式、吸引人参与,而私有评测集要难得多、也新得多。
他点出的数字很能说明问题:当时 Kaggle 半私有集排行榜的最高分只有 2.70%,而一些系统在更简单的公开演示集上能拿到高得多的分数。这个「公开集 vs 私有集」的鸿沟,正是他警告的核心——如果媒体、研究者、公司拿公开集的分数当作「在 ARC-AGI-3 上取得了进展」的证据,那就是在误读这个基准的真实难度。
也有声音对「所有顶尖 harness 都用同一种方法」这个断言本身的证据强度提出保留——Chollet 自己也承认这是「未经独立验证的观察」。但从 Agent 架构的角度看,这个趋势的方向性却很难被否认:当一个 LLM 在陌生环境里要「可靠地行动」时,把它产出的东西从「自然语言回答」升级为「可验证的代码」,几乎是一条自然的工程路径。
横向扩展:为什么这不只是 ARC 的事,而是 Agent 架构的事
Chollet 的「这不是只会在 ARC 上发光」,值得认真对待,因为它映射到一个正在发生的、更宏观的 Agent 架构转向。
想象一个要在真实、陌生、开放环境里工作的自主系统——一个要接入新 API 的 Agent,一个要在新工厂里操作机械臂的机器人,一个要处理没见过格式的文档的助手。它们面对的核心挑战,和 ARC-AGI-3 的解题者一模一样:从有限的观察里,推断出一个环境「如何运转」的可复用模型,然后用这个模型去可靠地行动。
传统的「纯 in-context 推理」——把观察塞进上下文、让 LLM 直接吐答案——在这种场景下会暴露一个致命弱点:LLM 的推理是不可验证、不可复用的。而「生成可执行代码」这个范式,恰好补齐了这个短板:LLM 产出的程序可以被跑、被测试、被调试、被复用,成为那个「可靠的、可复用的世界模型」。这正是为什么 Chollet 说,「能即时合成并执行符号世界模型的 Agent,会胜过那些只靠上下文推理的 Agent」。
这个转向对 Agent 平台的直接含义是:把「LLM 生成的代码」当作一等公民的输出,而不是附属功能。那些支持「生成代码 → 执行 → 验证 → 修正」闭环的工具链,会在这个趋势里占据有利位置。反过来,那些把 LLM 的输出局限在「自然语言」里的架构,可能会在需要可靠性的场景里逐渐掉队。
更深一层,这个判断其实回到了 Chollet 一个贯穿始终的思想:智能的本质是「技能习得效率」,而不是「技能存量」。一个系统真正的智能,不在于它「已经会了多少」,而在于它「面对全新任务时,能多快学会」。而「用直觉生成可执行的世界模型」,恰恰是「快速习得新技能」的一种具体机制——它不是靠海量数据把答案「背」下来,而是靠把环境的因果「建模」出来。
这也解释了 Chollet 那句「这是不可避免的」为何如此笃定:因为只要智能的定义是「泛化能力」,那么「可验证的、可复用的、显式的世界模型」就天然比「隐式的、一次性的 token 预测」更接近这个定义的终点。
ARC 系列七年的三次进化:一个「移动靶」的自我更新
Chollet 的「直觉引导的符号世界建模」判断,需要放在 ARC 系列七年的进化史里看,才能理解它为什么不是「一拍脑袋」,而是「被能力逼出来的结论」。
ARC 的第一次形态(ARC-AGI-1,2019),测的是「静态网格上的抽象推理」——给你几对输入输出网格,让你推断出变换规则,再应用到新网格上。它的设计目标是抵抗记忆化:每个任务都是全新的,所以靠「背答案」刷分是行不通的。在 2019 到 2024 年间,这个基准成功抵抗了主流的预训练-扩展范式——没有测试时适应的基座大模型,无法外推到没见过的任务。2020 年的第一次 Kaggle 竞赛,913 支队伍参赛,冠军用「穷举式程序搜索」(brute-force program search)在私有集上拿到约 20%。
但 2024 年 12 月,OpenAI 的 o3 在 ARC-AGI-1 上冲到了 87.5%,这个基准第一次被「攻破」。于是有了第二次形态(ARC-AGI-2,2025 年 3 月):保持网格形式,但把难度调向「多步组合、符号操作、顺序规则应用」,每个任务都用 400 名以上未经训练的人类被试校准,确保人类能解出所有保留的任务。结果,顶尖分数被重新压回约 4%,AI 和人类之间的差距被重新拉开。
第三次形态(ARC-AGI-3,2026 年 3 月 25 日),则是一次更彻底的范式升级——它不再测「单次的静态推理」,而是测「agentic intelligence」(智能体智能):探索陌生世界、构建内部模型、推断目标、规划执行。这个「从静态到交互」的转变,恰恰是 Chollet 那个「符号世界建模」判断的温床——因为在交互环境里,光靠「一次性 token 预测」根本走不通,你必须「建模」出环境的因果,才能在多回合里稳定行动。
理解这条进化线,就能理解 Chollet 的底气从哪来:他不是在空谈一个哲学,而是看着一个他自己设计的、持续升级的基准,在七年间把 AI 的「能力边界」一次次逼出来,然后从中观察到了那个反复出现的最优解法模式。这个观察的权重,远大于一个「我猜 AI 会往哪走」的普通预测。
一个必须澄清的边界:分数和「智能」不是一回事
Chollet 的判断之所以值得认真对待,还有一个原因:他对「分数」这件事,保持着一份在这个「刷分时代」里罕见的清醒。而这种清醒,恰恰是他「符号世界建模」判断的另一面。
在 8 月 14 日的同一组推文里,Chollet 除了背书「符号世界建模」,还专门花篇幅纠正一个正在发生的误读——关于 ARC-AGI-3 的「公开演示集」。他明确说,公开集是「演示集」,不是评测集,也不是训练集,它存在的目的是展示格式、吸引人来玩,分数不代表性。他用一个数字点破了问题的严重性:当时 Kaggle 半私有集排行榜的最高分只有 2.70%,而一些系统在更简单的公开演示集上能拿到高得多的分数。
这个「公开集 vs 私有集」的鸿沟,暴露的是一个更普遍的测量问题:当人们拿「容易的那部分」的分数,当作「整体能力」的证据时,就会系统性高估模型的真实水平。这种高估,会直接影响投资决策、能力声明,以及「Agent 是否已经准备好部署到不可预测的真实世界」的判断。
这套清醒,其实和 Chollet 的「符号世界建模」判断是同一枚硬币的两面:他之所以推崇「可执行、可验证的代码」,正是因为他深知「不可验证的 token 输出」有多容易被高估。一个 LLM 说它「解出了」一道题,和一段代码「真的跑通并给出正确结果」,是两种完全不同置信度的「能力声明」。Chollet 对前者的警惕,和对后者的推崇,源自同一个认识论立场——能被验证的,才值得相信。
这一点,在 2026 年 9 月那场关于 GPT-6 Astra 的争议里体现得淋漓尽致。当 OpenAI 宣称 Astra 在 ARC-AGI-3 上「饱和」、ARC Prize 基金会给出 62.7%(Standard)和 99.9%(Provider Adapter)两个天差地别的分数时,Chollet 式的清醒就显得尤其重要:99.9% 这个数字,有多少属于模型,有多少属于「外面那个保留隐藏推理的 harness」?当你连「分数」这个最基本的测量单位都信不过时,「符号世界建模」这种「把能力变成可验证代码」的思路,就更显得是一条更可靠的路。
总结与启示
Chollet 这次发言最值得记住的,不是「ARC-AGI-3 上谁拿了多少分」,而是他提炼出的那个范式分界——「让 LLM 直接推理」和「让 LLM 生成可验证的世界模型」是两条不同的路,而后者才是通往可靠智能的方向。
对从业者,这里有几个可以落地的启示。
其一,重新审视「LLM 的输出应该是什么」。当任务需要可靠性和可复用性时,考虑让 LLM 输出「可执行的代码」而不是「自然语言答案」。代码可以被测试、被审计、被复用,这是自然语言答案给不了的。
其二,把「验证闭环」当成架构的一部分,而不是事后的补丁。Chollet 背书的那个范式,核心不是「LLM 生成代码」这个动作,而是「生成 → 运行 → 验证 → 修正」这个闭环。没有闭环,「生成代码」和「胡言乱语」差别不大。
其三,对「基准分数」保持一份 Chollet 式的警惕。公开演示集的分数、特定 harness 下的分数、带隐藏推理的分数,都可能和「真实能力」相去甚远。读一个分数之前,先问:它测的是哪个集?用的什么 harness?模型有没有被「外面」的东西托着?
最后,Chollet 这个判断之所以值得反复咀嚼,是因为它把两个看似对立的东西——神经网络的「直觉」和符号系统的「精确」——放进了同一个框架里。他说的不是「符号主义要回归」,而是「神经网络和符号程序要各司其职」。如果你一直在纠结「深度学习够不够」或「符号方法过没过时」,Chollet 的答案是:别纠结了,把它们合起来用,这才是 AI 长期的走向。
参考来源
- François Chollet X 推文(2026-08-14,关于 ARC-AGI-3 与符号世界建模)
- AI Wiki《ARC-AGI》《ARC-AGI 3》
- The Agent Times《Chollet Warns ARC-AGI-3 Public Games Are Not a Benchmark》
- The Agent Times《Chollet Endorses LLM-Guided Symbolic World Modeling as Top ARC-AGI-3 Strategy》
- Chollet《On the Measure of Intelligence》(arXiv:1911.01547)